Effektives Red Teaming im Zeitalter der Agenten: Amazon Bedrock (Teil I)


Einleitung
KI-Red-Teaming erfordert spezialisierte Ansätze, die sich vom traditionellen Red Teaming unterscheiden. KI-Systeme, wie sie Amazon Bedrock nutzt, sind nicht deterministisch. Daher müssen effektive Testansätze eine größere Vielfalt an Möglichkeiten abdecken (hohe Entropie). Darüber hinaus sind die autonomen Entscheidungsfähigkeiten von KI anfällig für Angriffe wie Prompt Injection, bei denen böswillige Akteure die Systeme mit raffinierten Anweisungen austricksen und so zu unbeabsichtigtem Verhalten führen können. Diese inhärenten KI-Schwächen können die Servicequalität beeinträchtigen, doch KI-Red-Teaming bietet Möglichkeiten, diese Schwachstellen zu erkennen und zu beseitigen.
Dieser Artikel bietet praktische KI-Red-Teaming -Anleitungen für Amazon Bedrock mit Beispielen und Illustrationen. Er zielt darauf ab, eine erkennbare Lücke zu schließen; trotz der Verfügbarkeit verschiedener KI-Sicherheits-Frameworks sind spezifische Red-Teaming-Anleitungen für Amazon Bedrock selten. Wir verweisen jedoch auf relevante Quellen, darunter die Cloud Security Alliance, OWASP, MITRE ATT&CK und MITRE ATLAS.
Der erste Teil dieses Artikels behandelt KI-Red-Teaming im Rahmen des OWASP AI SecOps Frameworks und erörtert anschließend fünf Bedrock-Komponenten: Identitäts- und Zugriffsmanagement, Bedrock Agents, Protokollierung von Sicherheitsereignissen, Wissensdatenbanken und LLMJacking.
Red Teaming in AI SecOps
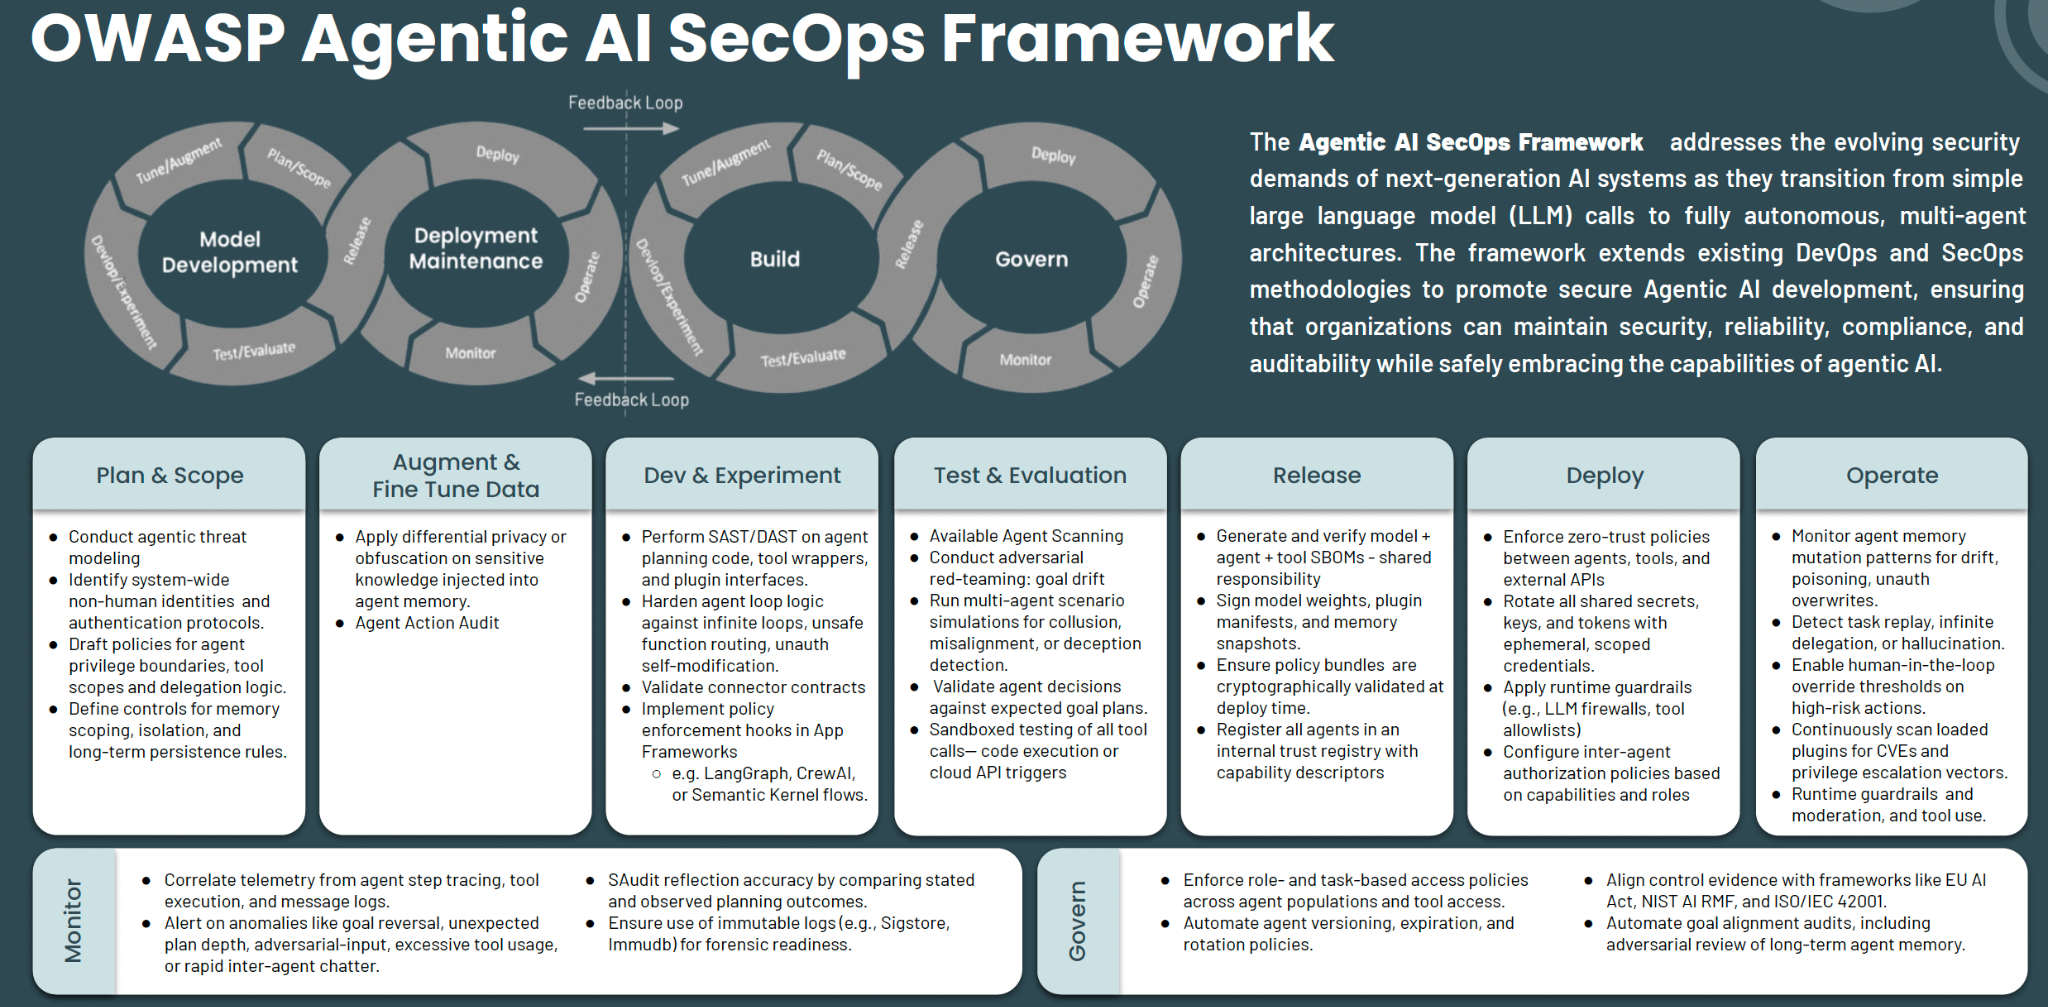
KI-Red-Teaming ist ein entscheidender Aspekt des KI-Sicherheitslebenszyklus. Das OWASP Agentic AI SecOps Framework ordnet adversarielle Tests primär in der Test- und Evaluierungsphase (T&E) ein. Diese Platzierung spiegelt den Fokus von OWASP auf Anwendungssicherheit wider, bei der Tests meist vor der Bereitstellung stattfinden. Die Sicherheit von Cloud-Infrastrukturen (einschließlich Red Teaming) erfordert jedoch aufgrund der Flüchtigkeit der Cloud Tests sowohl vor als auch nach der Bereitstellung. Da Bedrock in erster Linie eine Cloud-Infrastruktur und erst in zweiter Linie eine KI-Workload ist, sind die Beschreibungen im Framework nicht optimal; Modelle ändern sich, Prompts werden versioniert, Wissensdatenbanken nehmen neue Daten auf, neue Aktionsgruppen werden orchestriert, IAM-Berechtigungen driften ab und, was am wichtigsten ist: Die Bedrohungslandschaft entwickelt sich ständig weiter.
Daher ist kontinuierliches Red Teaming in der Betriebsphasezusätzlich zu anderen Aktivitäten in dieser Phase, bei denen es sich größtenteils um passives Monitoring handelt, unerlässlich. In dieser gesamten Serie betrachten wir Red Teaming als eine kontinuierliche Disziplin, die sich sowohl über die T&E - als auch über die Betriebs- phasen erstreckt.
Identität und Zugriff
Identität und Zugriff sind grundlegende Aspekte der Angriffsfläche von Bedrock. KI-Workloads, die in Bedrock bereitgestellt werden, verfügen über Identitäten, die in vielen Schichten gestapelt sind: AWS Identity and Access Management (IAM)-Rollen, Agenten-Servicerollen, Knowledge-Base-Servicerollen, Lambda-Ausführungsrollen für Aktionsgruppen, Rollen für Modellanpassungsaufträge sowie kurz- und langfristige Bedrock-API-Schlüssel.
Angreifer zielen auf Identitätslücken ab, um sich Erstzugriff zu verschaffen oder ihre Privilegien zu erweitern, sobald sie sich im System befinden. Sobald ein Angreifer über den richtigen Pfad zur Rollenübernahme verfügt, wird die Erkennung exponentiell schwieriger. Das Identitätsmanagement in Bedrock ist für die meisten Verteidiger relativ neues Terrain, weshalb Fehler, deren Aufdeckung in anderen AWS-Diensten wie EC2 und S3 Jahre dauerte, hier erneut auftreten.
Ziele des Red Teamings
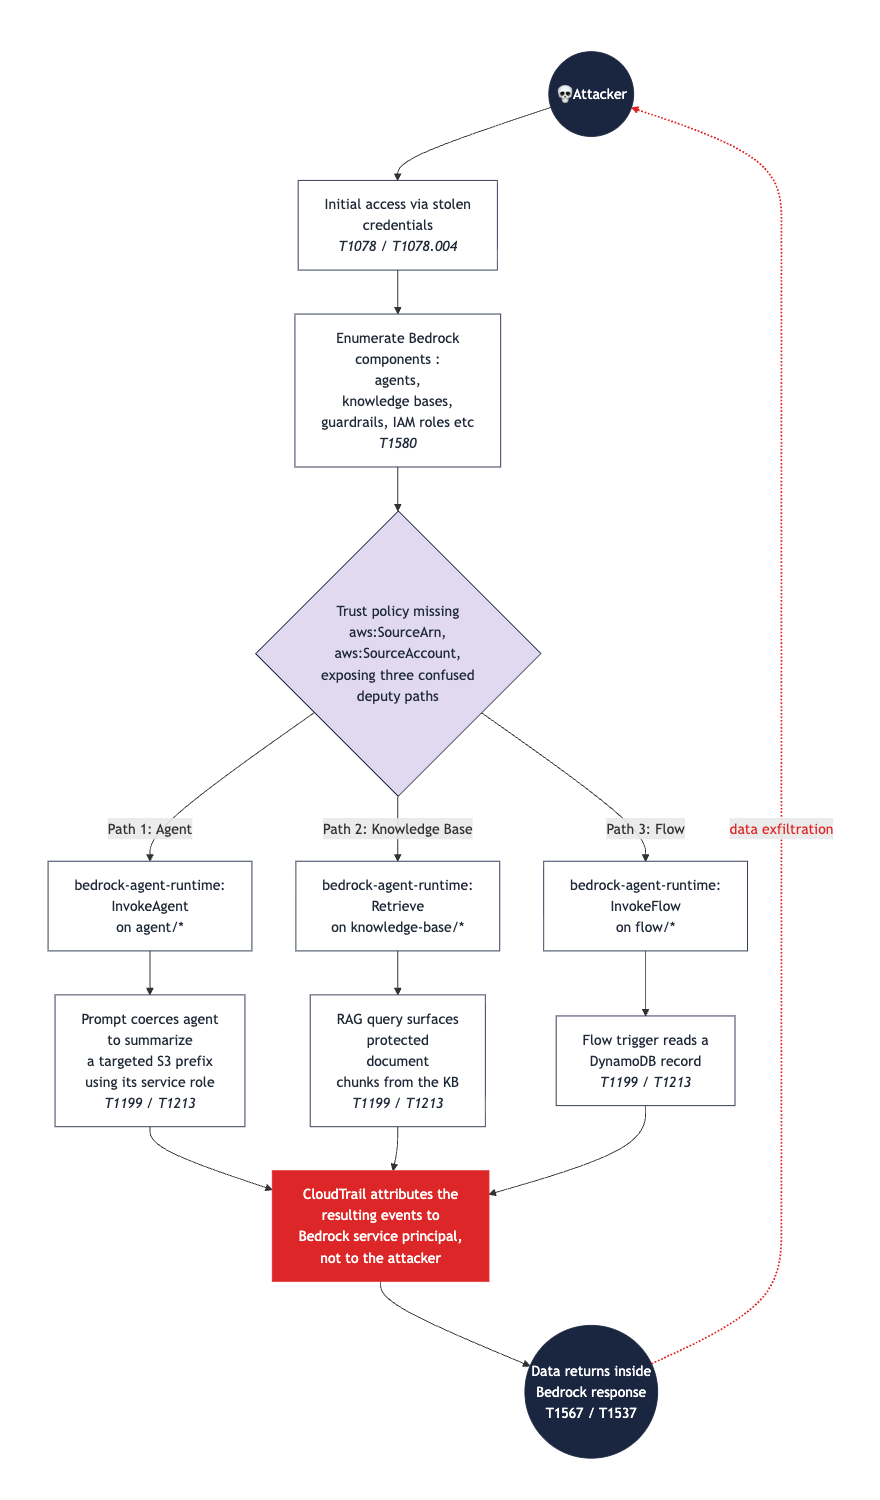
- Privilegieneskalation: Versuchen Sie, Privilegien von Identitäten mit niedrigen Rechten oder einer kompromittierten Bereitstellungspipeline zu eskalieren, indem Sie uneingeschränkte iam:PassRole-Berechtigungen missbrauchen, um Bedrock-Ressourcen, z. B. Agenten, hochprivilegierte Admin-Rollen zuzuweisen.
- Missbrauch von IAM-Rollen: Nutzen Sie zu weit gefasste, generische oder wiederverwendete Servicerollen aus, die von Agenten, Knowledge Bases und Aktionsgruppen gemeinsam genutzt werden, um sich seitwärts zwischen verschiedenen Anwendungsschichten zu bewegen und auf Datengrenzen zuzugreifen, die Ihnen eigentlich verborgen bleiben sollten.
- Ausnutzung des Confused-Deputy-Problems: Ausnutzen Schwachstellen durch verwirrte Stellvertreter (Confused Deputy) durch das Anvisieren schwacher oder unzureichend konfigurierter IAM-Rollen, denen restriktive Bedingungen wie
aws:SourceAccountoderaws:SourceArnfehlen. - Enumeration verwalteter Rollen: Nutzen Sie AWS-verwaltete Standardrollen (wie AmazonBedrockFullAccess), um überprivilegierte Anmeldeinformationen zu finden, die Aktionen wie das Löschen benutzerdefinierter Modelle, die Manipulation bereitgestellter Durchsatzraten oder den Kauf nicht autorisierter Marketplace-Angebote ermöglichen.
- Erfassung von Anmeldeinformationen & Umgehung von SCPs: Durchsuchen Sie Code-Repositories und Umgebungsprotokolle nach hartcodierten, langfristigen API-Schlüsseln oder Bearer-Tokens und verwenden Sie diese, um Befehle aus nicht genehmigten Netzwerken oder Regionen auszuführen und so auf fehlende globale SCPs (Service Control Policies) zu prüfen.
Verwandte Referenzen
Entspricht dem CSA Agentic AI Red Teaming Guide §4.1 (Agent Authorization and Control Hijacking), MITRE T1098 (Account Manipulation), OWASP LLM06 (Excessive Agency).
Bedrock Agents
Bedrock Agents fungieren als autonome Orchestratoren, die ein Basismodell, Systemanweisungen, verknüpfte Wissensdatenbanken, Aktionsgruppen für Tool-Aufrufe und eine mehrstufige Logikschleife kombinieren. Da sie darauf ausgelegt sind, nicht vertrauenswürdige externe Inhalte (RAG-Quellen, Tool-Ausgaben, Web-Antworten) als Teil ihres normalen Ausführungszyklus zu verarbeiten, schaffen sie einen völlig dynamischen Ausführungsperimeter. Wir haben bereits einen detaillierten Einblick gegeben, wie Angreifer Bedrock Agents, einschließlich Wissensdatenbanken und RAG, kompromittieren; weitere Einzelheiten finden Sie in diesem Blog: Bedrock oder Bedsand: Attacking Amazon Bedrock's Achilles Heel.

Da Agenten Ziele übernehmen, Werkzeuge auswählen und mehrstufige Aktionen ausführen, ohne dass jeder Schritt von einem Menschen überprüft wird, stellen sie ein erhebliches Haftungsrisiko dar. LLMs können von sich aus nicht zwischen grundlegenden Code-Anweisungen und nicht vertrauenswürdigen Dateneingaben unterscheiden. Folglich kann sich bösartiger Inhalt, den ein Angreifer in einer externen Quelle platziert hat, leicht in ein Ziel verwandeln, das der Agent im Namen des Benutzers aggressiv verfolgt.
Ziele des Red Teamings
- Indirekte Prompt-Injection: Platzieren Sie versteckte Anweisungen in verknüpften Wissensdatenbank-Dokumenten oder simulierten externen Web-Antworten, um den Ausführungsfluss des Agenten zu kapern und ihn zu unbefugten Aufgaben zu zwingen.
- Ziel-Hijacking: Untergraben Sie die Kernsystemanweisungen des Agenten, indem Sie widersprüchliche Anweisungen über Benutzereingabefelder oder Laufzeit-Prompt-Variablen einschleusen, um seine beabsichtigte Mission umzuschreiben.
- Ausnutzung übermäßiger Berechtigungen von Agentenrollen: Täuschen Sie einen Agenten dazu, destruktive oder eingeschränkte AWS-Infrastrukturvorgänge aufzurufen, um zu prüfen, ob seine zugewiesene Servicerolle über zu weitreichende Berechtigungen verfügt.
- Manipulation der Übergabe zwischen Supervisor und Subagent: Fangen Sie Payloads ab oder manipulieren Sie diese, die zwischen koordinierten Multi-Agenten-Architekturen übertragen werden, um bösartigen Code in den Ausführungskontext des nachgelagerten Subagenten einzuschleusen.
- Ausbruch aus dem Gültigkeitsbereich: Zwingen Sie die mehrstufige Logikschleife des Agenten aus ihrem begrenzten Rahmen und nötigen Sie ihn dazu, mit nicht genehmigten Systemwerkzeugen oder anderen AWS-Diensten zu interagieren.
Weiterführende Referenzen
Entspricht dem CSA Agentic AI Red Teaming Guide §4.4 (Ziel- und Anweisungsmanipulation) und §4.5 (Ausnutzung von Halluzinationen), MITRE ATLAS AML.T0051 (LLM Prompt Injection), OWASP LLM06 (Übermäßige Handlungsfähigkeit).
Protokollierung von Sicherheitsereignissen
Die Sicherheitstransparenz von Bedrock ist über mehrere unabhängige Protokollierungsebenen fragmentiert: AWS CloudTrail für Konfigurationsänderungen der Steuerungsebene, Modellaufruf-Protokollierung für Roh-Prompts und -Vervollständigungen, Lambda-Ausführungsprotokolle für das Verhalten von Aktionsgruppen sowie individuelle S3- oder OpenSearch-Audit-Trails für den Zugriff auf Wissensdatenbanken.
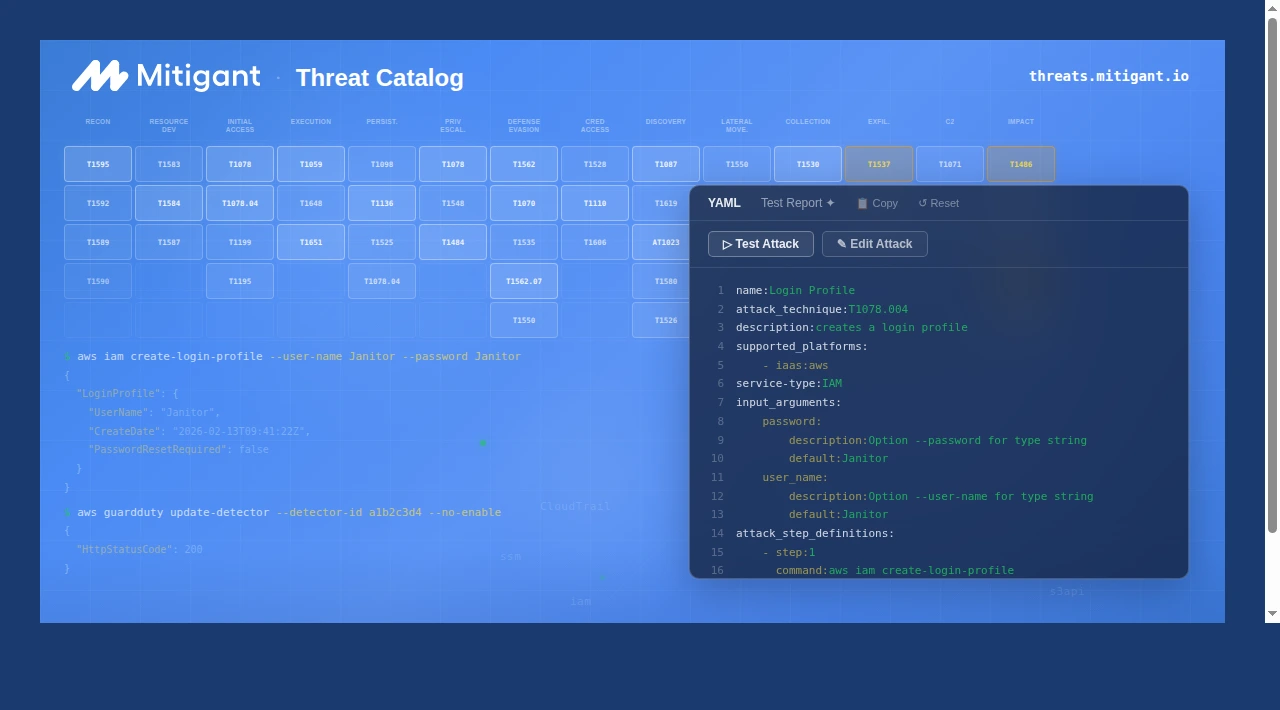
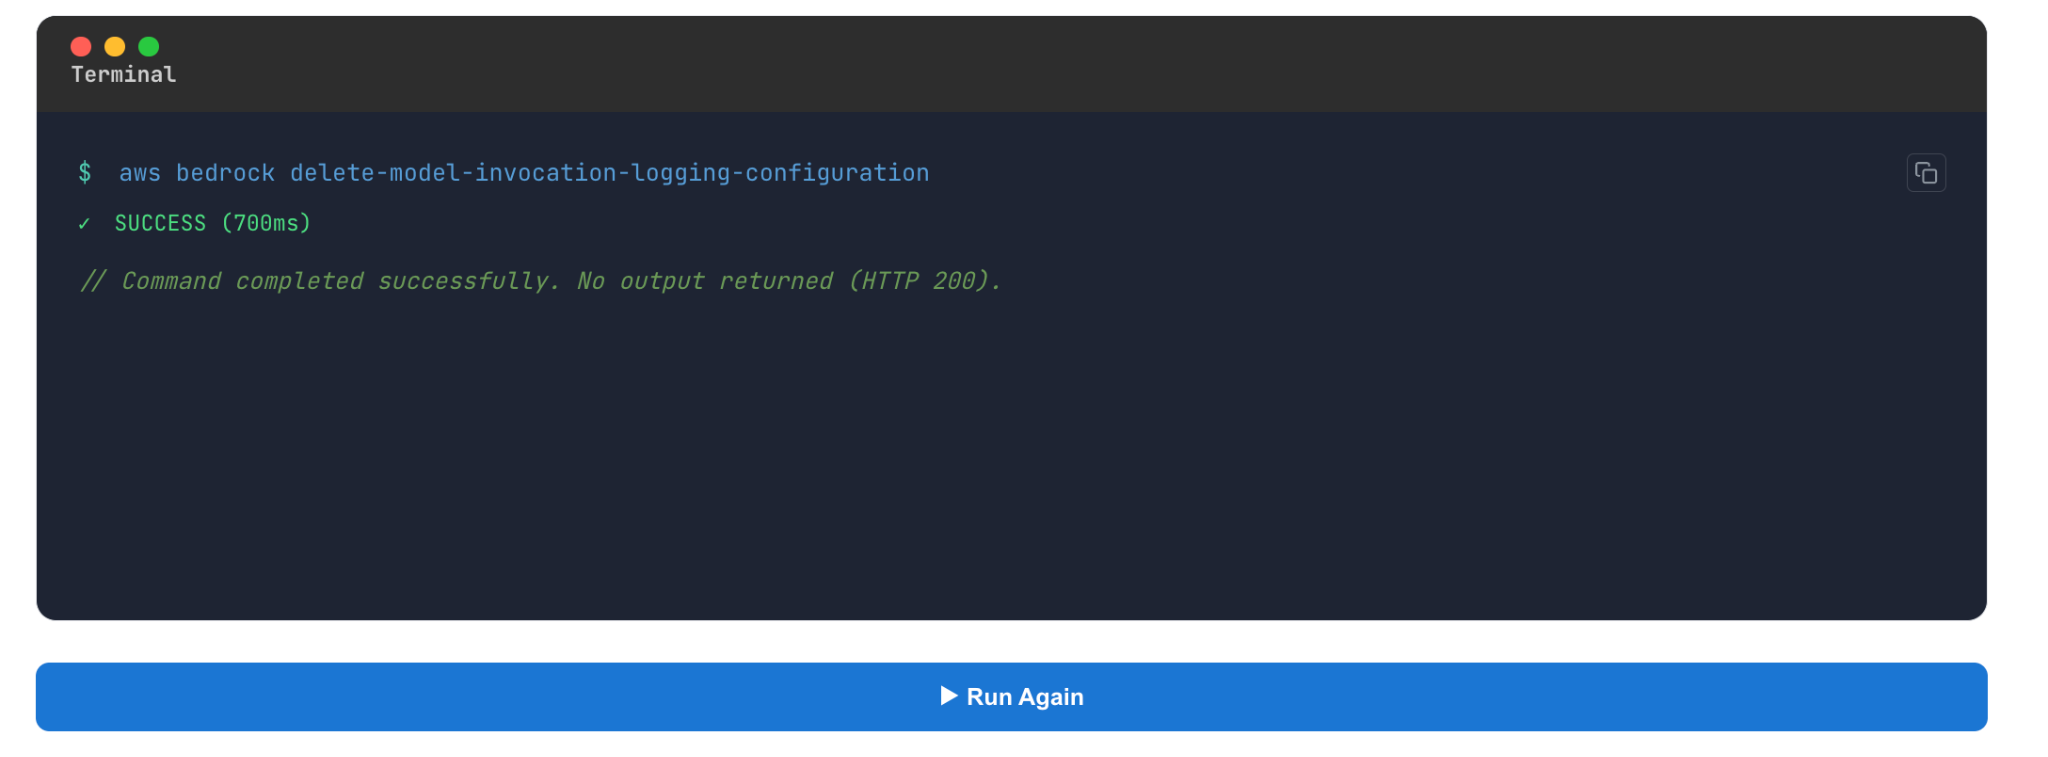
Jede Protokollierungsebene überwacht einen eigenen Angriffsvektor der gesamten Angriffsfläche; daher erfordert eine umfassende Transparenz die Aggregation und Verarbeitung der Protokolle. CloudTrail deckt Konfigurations- oder Identitätsmanipulationen auf, während Modellaufruf-Protokolle der einzige Mechanismus sind, um Jailbreaks, Prompt-Injections und das Umgehen von Guardrails zu erkennen. Da kritische Deep-Telemetrie-Ebenen, wie die Aufruf-Protokollierung, standardmäßig deaktiviert sind, kann eine aktive Kompromittierung unbemerkt bleiben. Sie können diesen Befehl ganz einfach im Mitigant Threat Catalog ausführen; probieren Sie es hier aus.
Ziele des Red Teaming
- Ausnutzung von blinden Flecken: Führen Sie Maßnahmen zur Umgehung der Verteidigung durch (wie Datenexfiltration oder Modellaufrufe) in Regionen, in denen die CloudTrail-Protokollierung oder das regionsübergreifende Tracking möglicherweise nicht konfiguriert oder verzögert ist.
- Nicht überwachte Injection-Angriffe: Führen Sie Jailbreak-Payloads und indirekte Prompt-Injections aus, um gezielt zu prüfen, ob die Protokollierung von Modellaufrufen standardmäßig deaktiviert ist.
- Verschleierung der Ausführungsspuren: Missbrauchen oder deaktivieren Sie zugrunde liegende Lambda-Funktionen innerhalb von Action Groups, um Code unbemerkt auszuführen, ohne eine detaillierte Anwendungsverfolgung in Amazon CloudWatch auszulösen.
- Infiltration der Datenebene: Fragen Sie Vektordatenbanken und zugrunde liegende Daten-Buckets mit ungewöhnlichen, hochfrequenten Extraktionsmustern ab, um zu testen, ob Zugriffsprotokolle (S3-Serverprotokolle oder OpenSearch-Audit-Streams) keine defensiven Alarme auslösen.
- Unterbrechung der Telemetrie: Versuchen Sie, das Löschen, Ändern oder Anhalten der Aufnahme von Bedrock-Protokollen in das SIEM des Unternehmens zu erzwingen, um Ihre Spuren während einer aktiven Ausnutzung zu verwischen.
Weiterführende Referenzen
Entspricht dem CSA Agentic AI Red Teaming Guide §4.12 (Agent Untraceability), MITRE T1562 (Impair Defenses).
Knowledge Bases
Knowledge Bases sind die zentrale Komponente für die RAG-Funktionen (Retrieval-Augmented Generation) von Bedrock. Sie rufen Dokumente aus Unternehmens-Repositories (wie S3, Confluence oder SharePoint) ab, um Anwendungen fundierten und autoritativen Kontext bereitzustellen, ohne dass die zugrunde liegenden Modelle ständig neu trainiert werden müssen. Die Angriffsfläche und die damit verbundenen Bedrohungen bei der Nutzung von S3 als Datenquelle (Datenvergiftung, Denial-of-Service, S3-Ransomware) werden in unserem früheren Beitrag ausführlich behandelt: Bedrock oder Bedsand: Angriff auf die Achillesferse von Amazon Bedrock.
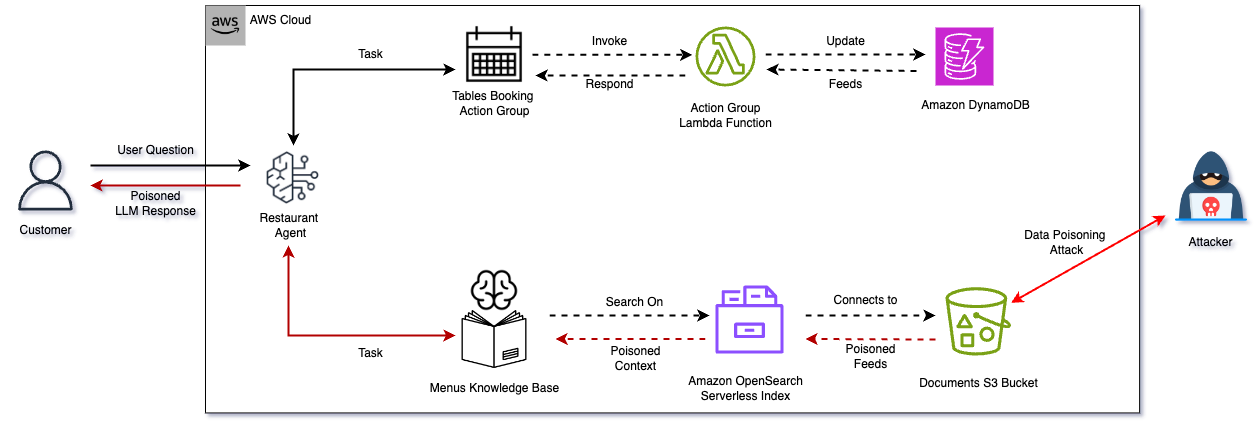
Abgerufene Datenfragmente werden vom Modell als absolute, verifizierte Wahrheit behandelt. Dies macht Wissensdatenbanken zu einem erstklassigen Ziel für Context-Poisoning-Angriffe. Im Gegensatz zu Jailbreaks im direkten Chat bleibt ein vergifteter Datenbestand unbemerkt über mehrere Benutzersitzungen hinweg bestehen, umgeht herkömmliche Inhaltsfilter für Benutzereingaben und erscheint für Endanwender, die die Systemausgabe überprüfen, als vollkommen legitim. Der CSA Agentic AI Red Teaming Guide führt Knowledge Base Poisoning als eigenständige Bedrohungskategorie, die das Vergiften von Trainingsdaten, die Manipulation externer Wissensquellen, die Korruption von Wissensdatenbanken, Schwachstellen im Aktualisierungsmechanismus sowie das agentenübergreifende Teilen von Wissensdatenbanken umfasst.
Ziele des Red Teamings
- RAG-Kontext-Poisoning: Einschleusen bösartiger Datenvarianten, Falschinformationen oder kodierter Anweisungen direkt in Quelldateien, um die nachgelagerte Entscheidungsmatrix des Agenten zu kompromittieren.
- Ausnutzung des Schreibzugriffs: Nutzung schwacher Zugriffsberechtigungen auf vorgelagerte Speichersysteme (S3-Buckets, öffentliche Wikis, Web-Scraper), um legitime Wissensbestände mit schädlichen Payloads zu überschreiben.
- Manipulation des Vektorspeichers: Umgehung der herkömmlichen Dokumenten-Ingestion-Pipeline durch direktes Einschleusen oder Mutieren von Embeddings in der Vektordatenbank, wodurch Suchergebnisse korrumpiert werden.
- Persistenzprüfung: Bewertung, wie lange ein vergiftetes Fragment im System-Cache über verschiedene Benutzersitzungen hinweg aktiv und unentdeckt bleiben kann, ohne automatisierte Integritätswarnungen auszulösen.
- Mandantenübergreifende Datenextraktion: Ausnutzung schlecht isolierter Vektorspeicher-Namespaces oder schwacher Metadatenfilter auf Zeilenebene, um Abfragen abzugreifen und Daten aus anderen Mandantenumgebungen zu stehlen.
Weiterführende Referenzen
Entspricht CSA Agentic AI Red Teaming Guide §4.7 (Agent Knowledge Base Poisoning), MITRE ATLAS AML.T0020 (Poisoning Training Data), OWASP LLM08 (Vector and Embedding Weaknesses).
LLMJacking
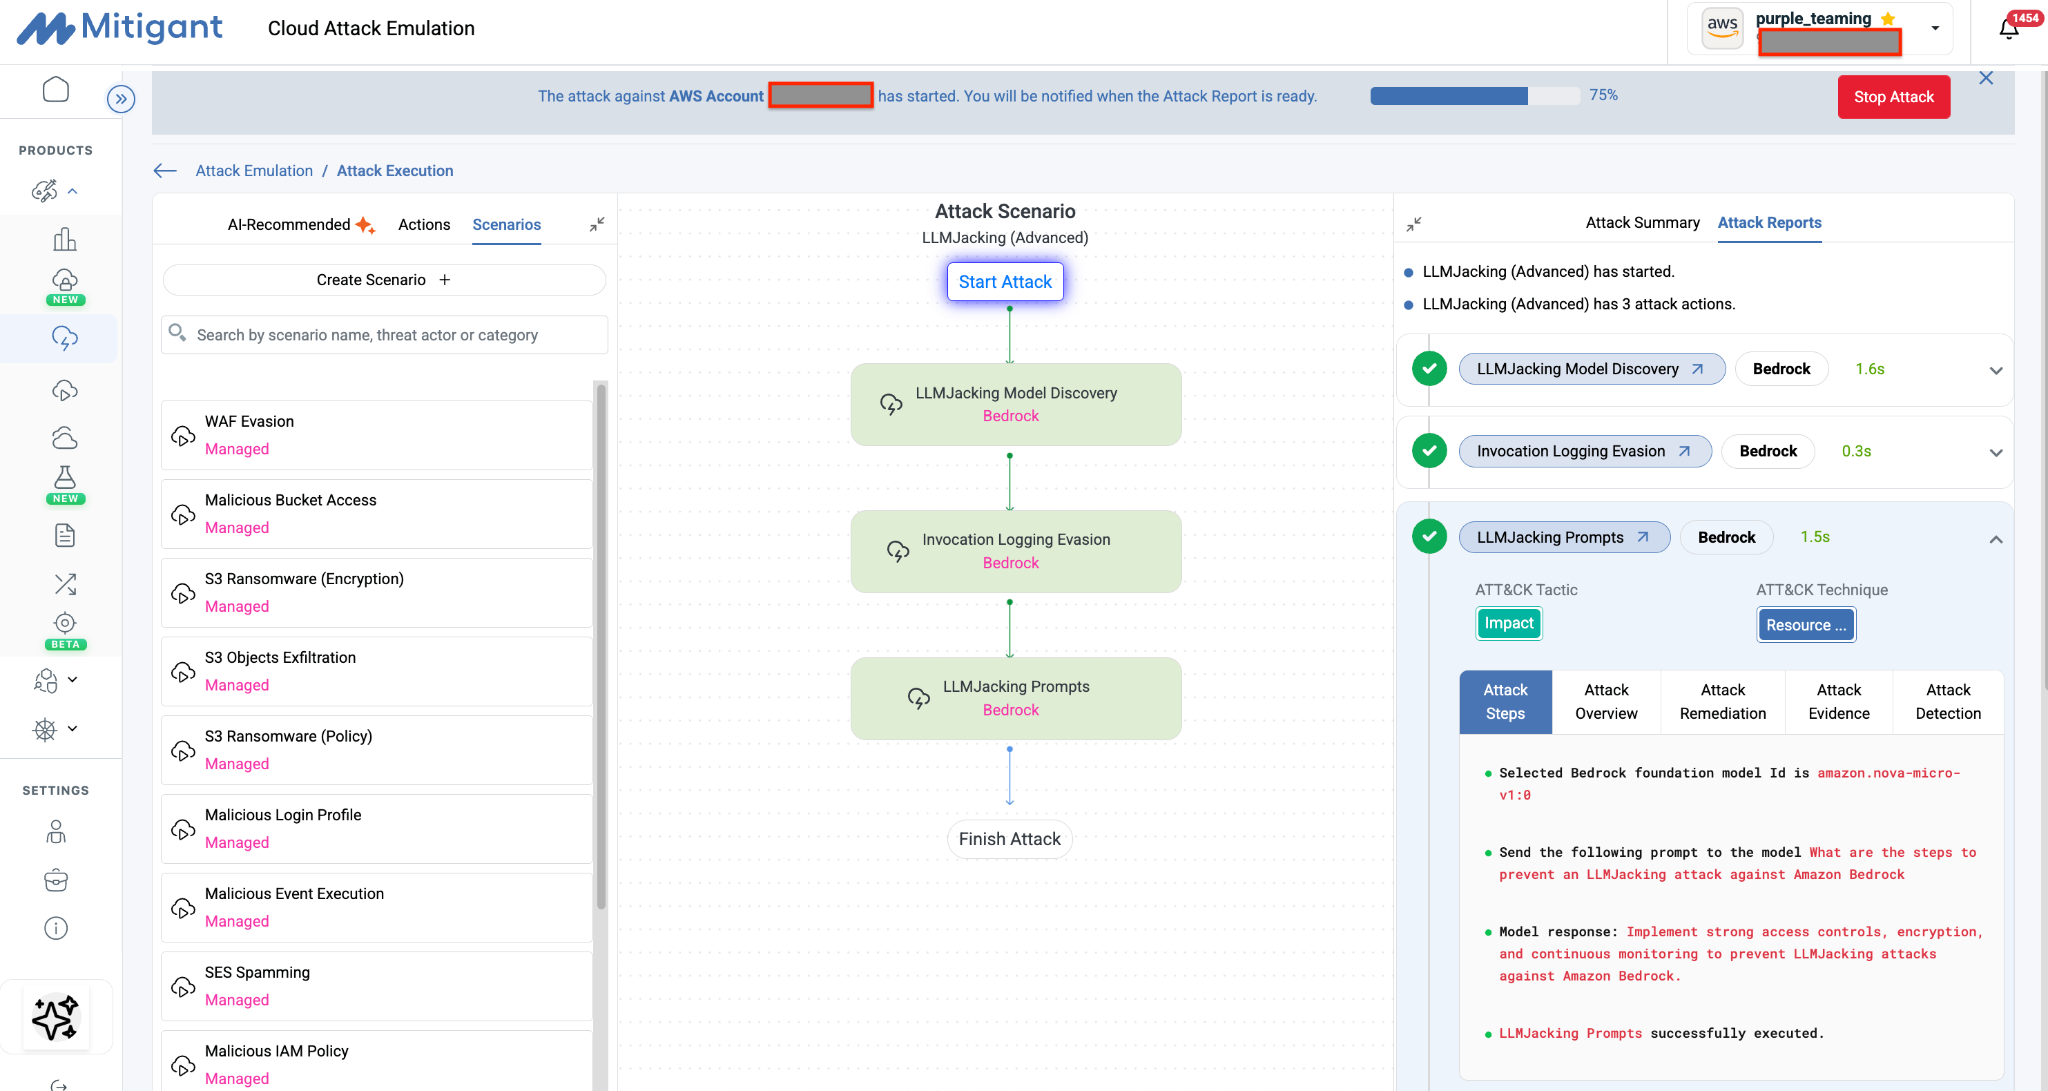
LLMJacking beschreibt einen Angriffsvektor, bei dem kompromittierte oder gestohlene Cloud-Zugangsdaten verwendet werden, um zugrunde liegende Basismodelle im Cloud-Konto eines Opfers aufzurufen. Da Bedrock alle aktivierten Modelle über eine optimierte, einheitliche Aufruf-API ohne standardmäßige Ausgabenlimits bereitstellt, kann jede Identität mit ausreichenden Berechtigungen massive Anforderungsvolumina auslösen. Wir haben diese Angriffsklasse in einem früheren Blogbeitrag ausführlich dokumentiert: Amazon Bedrock LLMJacking-Angriffe entmystifiziert.
Da die Nutzung von Basismodellen strikt pro Token abgerechnet wird, skaliert der finanzielle Schaden exponentiell mit der Geschwindigkeit automatisierter Angreifer-Schleifen. Angreifer nutzen dies aktiv aus, um Reverse-Proxy-API-Spiegel zu erstellen, Ihr unternehmenseigenes Bedrock-Kontingent an bösartige externe Netzwerke weiterzuverkaufen und ein einfaches Datenleck in eine dauerhafte, unüberwachte betriebliche Belastung zu verwandeln.
Ziele des Red Teamings
- Umgehung der Modellauswahl: Versuchen Sie, regionalspezifische oder kostenbegrenzte Umgebungen durch den Aufruf von LLMs zu umgehen, insbesondere dort, wo keine Einschränkungen wie SCPs bestehen.
- Ressourcenerschöpfung: Starten Sie eine Flut von API-Anfragen an LLMs, um zu testen, ob der Infrastruktur Echtzeit-Parallelitätsbegrenzungen oder Ratenbegrenzungsmaßnahmen fehlen.
- Missbrauch der regionsübergreifenden Inferenz: Leiten Sie Anfragen an regionsübergreifende Inferenzprofile weiter, um unüberwachte geografische Endpunkte auszunutzen und Ihre betrieblichen Verbrauchsspitzen zu verschleiern.
- Aufklärung und Erkundung: Missbrauchen Sie Metadaten-APIs (ListFoundationModels, GetFoundationModelAvailability), um systematisch verfügbare, hochwertige Ziele zu erfassen.
- SLA/Alarm-Wettlauf: Messen Sie, wie viel finanzieller Schaden in einem kurzen Zeitraum angerichtet werden kann, bevor die unternehmenseigene Überwachung von Kostenanomalien oder Cloud-Ausgabenwarnungen schließlich eine administrative Sperre auslöst.
Weiterführende Referenzen
Bezieht sich auf den CSA Agentic AI Red Teaming Guide §4.10 (Agent Resource and Service Exhaustion), insbesondere §4.10.5 (Economic Denial of Service), MITRE ATLAS AML.T0029 (Denial of ML Service), OWASP LLM10 (Unbounded Consumption).
Kontinuierliches KI-Red-Teaming mit Mitigant
Dieser Artikel bot wichtige Anleitungen zur Durchführung von Red Teaming für Amazon Bedrock und behandelte fünf Kernkomponenten. Der zweite Teil des Artikels wird weitere fünf behandeln: Angriffe auf benutzerdefinierte Modelle, Prompt-Management, Umgehung von Guardrails, Aktionsgruppen und Tool-Missbrauch sowie AgentCore.
Im Gegensatz zu herkömmlichen Workloads hängt die Qualität von KI-Workloads maßgeblich von AI Red Teaming ab; Nutzer können leicht frustriert oder sogar geschädigt werden, wenn Workloads falsche oder schädliche Ergebnisse liefern. Folglich ist AI Red Teaming eine unverzichtbare Investition für Unternehmen, die KI auf AWS einsetzen.
Die Mitigant-Plattform ermöglicht es Sicherheitsteams jeder Größe, AI Red Teaming für Amazon Bedrock sicher durchzuführen. Die Plattform wurde entwickelt, um die aktuelle Wissenslücke im Bereich der KI-Sicherheit zu schließen und den mit offensiver Sicherheit verbundenen Aufwand zu reduzieren, wie z. B. die Einrichtung der Umgebung, Angriffsanalysen, Automatisierungen und Bereinigungen. Sicherheitsteams können jede der oben beschriebenen Maßnahmen problemlos implementieren mithilfe von Mitigant Cloud Attack Emulation.
Starten Sie Ihre kostenlose Testversion unter mitigant.io/sign-up